01 / 研究问题
标签稀少、类别不均衡时,分子性质模型能否有效适配?
02 / 创新思路
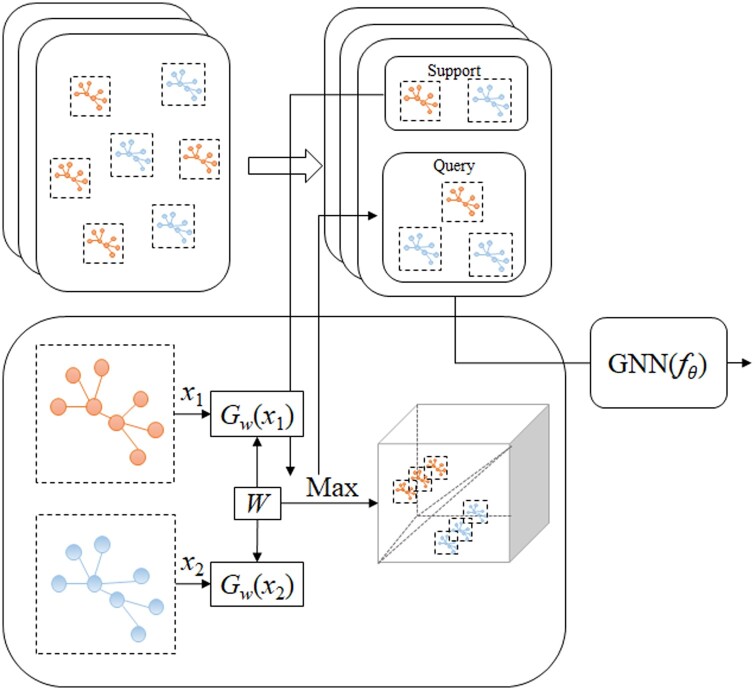
结合预训练分子图编码器、少样本适配与强调困难样本的动态对比目标。
03 / 方法机制
预训练 HuGIN 或 ChemBERTa 编码器通过少样本学习适应任务;交叉熵与类间对比损失结合,指数调度逐步降低对困难负样本的强调。
04 / 实验设置
Table 1:Tox21 8,014 个分子(训练/测试任务 9/3),SIDER 1,427(21/6),MUV 93,127(12/5),ToxCast 8,615(450/167)。前三者沿用既有任务划分,ToxCast 随机划分任务。Table 3 报告十个随机种子的查询集 ROC-AUC,与十种基线比较;基线值引用既有研究。
Published article · 2024 · Table 3 · 来源 ↗
05 / 主结果
10-shot 时,四个数据集的 AUC 均高于 Pre-PAR;1-shot 时,Tox21、SIDER 低于 Pre-PAR。
10-shot AUC(%)· 十次运行均值 ± 标准差 · Published article · 2024 · Table 3 · 数据来源 ↗
刻度:0 → 100
| 条件 | 指标 / 系列 | 报告值 |
|---|---|---|
| Tox21 | 10-shot AUC(%)· 十次运行均值 ± 标准差 | 85.93 ± 0.10% |
| SIDER | 10-shot AUC(%)· 十次运行均值 ± 标准差 | 79.08 ± 0.14% |
| MUV | 10-shot AUC(%)· 十次运行均值 ± 标准差 | 72.96 ± 1.18% |
| ToxCast | 10-shot AUC(%)· 十次运行均值 ± 标准差 | 76.39 ± 1.52% |
数值对应上述版本与实验条件;不同指标不构成统一排名。
ROC-AUC(%),十个种子的均值 ± 标准差;Pre-PAR 数值由论文引用。
横向滑动,或聚焦后按方向键查看全部列 →
| 数据集 | Pre-PAR 10-shot | MolFeSCue 10-shot | Pre-PAR 1-shot | MolFeSCue 1-shot |
|---|---|---|---|---|
| Tox21 | 84.93 ± 0.11 | 85.93 ± 0.10 | 83.01 ± 0.09 | 82.05 ± 0.11 |
| SIDER | 78.08 ± 0.16 | 79.08 ± 0.14 | 74.46 ± 0.29 | 73.13 ± 0.56 |
| MUV | 69.96 ± 1.37 | 72.96 ± 1.18 | 66.94 ± 1.12 | 67.32 ± 1.08 |
| ToxCast | 75.12 ± 0.84 | 76.39 ± 1.52 | 73.63 ± 1.00 | 74.82 ± 1.39 |
Published article · Table 3 · 原文来源 ↗
06 / 消融与局限
Figures 3–4 分别去掉预训练初始化、对比损失或动态调度。Figure 3 正文的 SIDER 数值与 Table 3 不同,因此不混入主比较。任务迁移和不平衡数据的 ROC-AUC 不等于前瞻性筛选命中率。
收益依赖支持样本数和数据集;并非所有 1-shot 比较都领先。
07 / 个人贡献
第一作者。
08 / 论文与代码
引用这项研究
MolFeSCue: enhancing molecular property prediction in data-limited and imbalanced contexts using few-shot and contrastive learning. Bioinformatics · 40(4), btae118, 2024. https://academic.oup.com/bioinformatics/article/40/4/btae118/7616990