01 / 研究问题
除了常见氨基酸,模型怎样读懂含非天然氨基酸的多肽?
02 / 创新思路
利用异构图在原子与片段尺度学习,结合片段掩码自监督,以及从天然到非天然多肽的预训练适配。
03 / 方法机制
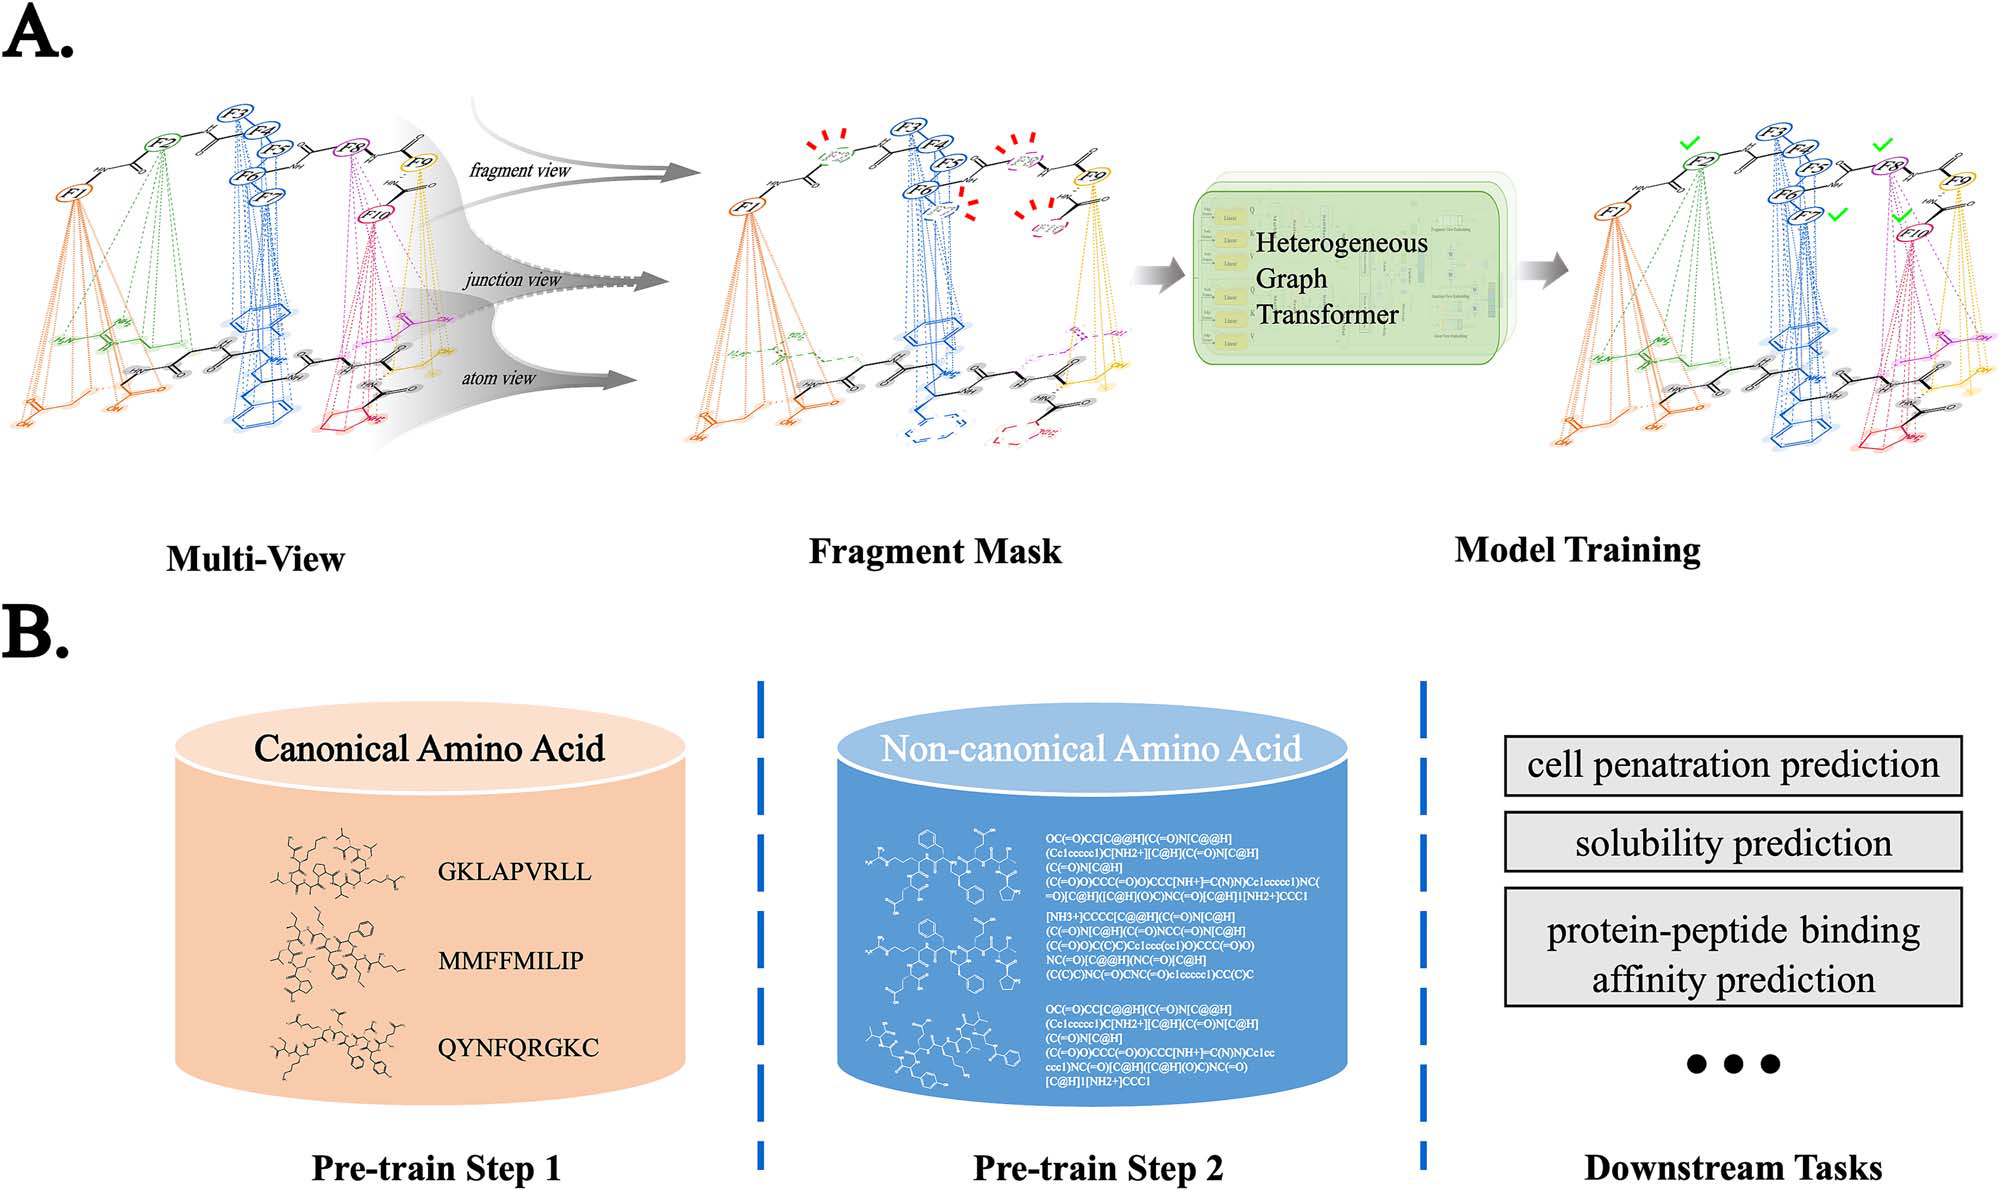
AdaFrag 结合氨基酸切分与 BRICS 侧链片段,原子、片段与连接关系在异构图中交换信息。掩码预训练先学习天然化学,再适应非天然多肽。
04 / 实验设置
2023 作者稿的第一阶段含 7,924,509 个样本,第二阶段含 8,977 条非天然多肽。下游包括 CPP(1,162 正例/1,162 负例)、短序列 PROSO-II 溶解度及亲和力,与 ESM 和小分子编码器比较。所读正文未给出下游精确划分比例。
Author manuscript · 2023 · Tables 2, 3, 5 · 来源 ↗
05 / 主结果
两阶段训练的非天然亲和力 PCC 达 0.873;天然 CPP AUC 为 0.838,低于 ESM 的 0.885。这些属于 2023 作者稿,不是 2025 期刊表。
ORIGINAL FIGURE / PAPER SOURCE
方法如何工作。
AdaFrag 在氨基酸切分之外引入 BRICS 侧链片段,把天然与非天然化学放入同一原子/片段异构图。掩码学习先建立表征,再通过两阶段预训练适配非天然多肽。
REPORTED COMPARISON / SAME-PAPER CONDITIONS
比较结果,也保留不领先的地方。
2023 年公开作者稿的报告结果;数值对应该版本,而非最终期刊表格。 查原表 ↗
横向滑动或聚焦后用方向键查看全部列 →
| 模型 | AUC ↑ |
|---|---|
| ESM | 0.885 |
| PepLand | 0.838 |
| ESM + PepLand | 0.885 |
PepLand 单独在这个天然 CPP 任务上低于 ESM;非天然任务是其重要研究重点。跨论文的数据划分与协议未对齐,不做横向排行榜。
ABLATION / WHAT CHANGES THE RESULT?
把机制拆开,看它是否有用。
横向滑动或聚焦后用方向键查看全部列 →
| 条件 | 任务 / 指标 | 报告值 |
|---|---|---|
| Amiibo | 非天然亲和力 SCC | 0.708 |
| AdaFrag | 非天然亲和力 SCC | 0.749 |
| Amiibo → AdaFrag | 溶解度 F1 | 0.696 → 0.693 |
| 单阶段 → 两阶段 | 非天然亲和力 PCC | 0.827 → 0.873 |
| 单阶段 → 两阶段 | 天然亲和力 PCC | 0.496 → 0.450 |
来源:2023 作者稿 Tables 3、5。侧链片段和两阶段训练并非对所有指标都有增益。
A BOUNDED CASE / REPRESENTATIONS IN CONTEXT
回到具体的多肽问题。
06 / 消融与局限
Tables 3–5 比较片段化、掩码及训练阶段。两阶段使非天然亲和力 PCC 从 0.827 提升至 0.873,但天然亲和力 PCC 从 0.496 降至 0.450。表征质量依赖任务,小规模回顾性案例不证明前瞻性候选发现。
表征学习并不等于实验确认了治疗候选。泛化能力需要结合具体任务、数据划分与评测条件判断。
07 / 个人贡献
第一作者。
08 / 论文与代码
引用这项研究
PepLand: a large-scale pre-trained peptide representation model for a comprehensive landscape of both canonical and non-canonical amino acids. Briefings in Bioinformatics · 26(4), bbaf367, 2025. https://academic.oup.com/bib/article/26/4/bbaf367/8220755